FinOps
Facture Datadog qui explose : les leviers concrets sur logs, métriques et APM
Logs indexés en trop, cardinalité de métriques hors de contrôle, APM activé partout : les trois postes qui font déraper Datadog, et les leviers Terraform pour les reprendre en main sans perdre en visibilité.
Le scénario revient dans presque tous les audits FinOps que nous menons : Datadog a été activé sur deux ou trois hôtes pour un besoin ponctuel, l’équipe a adoré l’outil, l’instrumentation s’est étendue service par service — et douze mois plus tard, la facture de renouvellement arrive avec un montant 2 à 3 fois supérieur à ce qui avait été budgété. Personne n’a menti sur le nombre de serveurs. Ce qui a dérapé, c’est ce qui se passe entre les serveurs et la facture : combien de logs sont indexés plutôt que juste ingérés, combien de combinaisons de tags génèrent des métriques custom, et sur combien d’hôtes l’APM tourne réellement pour un usage réel.
Ce n’est pas un article “faut-il quitter Datadog” — nous en avons déjà traité l’arbitrage avec CloudWatch dans notre comparatif dédié. C’est un article pour les équipes qui gardent Datadog (à raison, souvent) mais veulent reprendre le contrôle de la facture sans perdre en visibilité opérationnelle.
Où part l’argent, concrètement
Trois postes concentrent la quasi-totalité du dérapage, dans cet ordre de fréquence observée :
- L’indexation des logs. Ingérer coûte 0,10 $/Go — c’est le prix d’entrée, presque négligeable. Indexer coûte 1,70 $ par million d’événements en engagement annuel (2,55 $ à la demande) à 15 jours de rétention. Le piège : par défaut, tout ce qui est ingéré est indexé. Une équipe qui envoie ses logs applicatifs bruts sans filtrage indexe des
DEBUGet des heartbeats de health check au même tarif que ses erreurs 500. - La cardinalité des métriques custom. Le plan Pro inclut 100 métriques custom par hôte — généreux en apparence. Mais une métrique Datadog est définie par la combinaison nom + valeurs de tags. Ajouter un tag
customer_id,request_idoupod_nameà haute cardinalité sur une métrique existante peut la faire exploser en des milliers de séries facturables sans qu’aucun humain n’ait ajouté un serveur. - L’APM activé par réflexe. À 31 $/hôte/mois (bundle infra incluse, plan de base), l’APM est le poste le plus cher par hôte. Beaucoup d’équipes l’activent sur l’intégralité de la flotte “au cas où”, y compris sur des workers batch ou des instances de staging qui ne génèrent jamais d’incident nécessitant du tracing distribué.
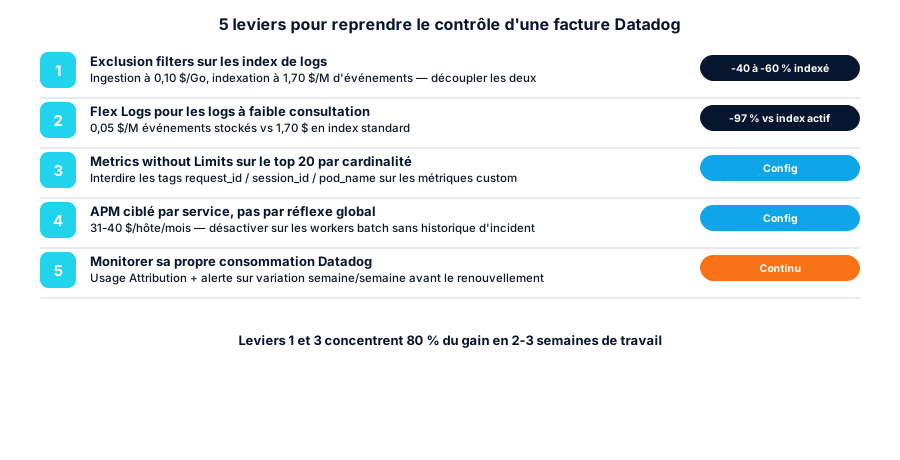
Levier 1 — Ingérer large, indexer étroit
La bonne pratique n’est pas de réduire l’ingestion (elle est déjà bon marché et sert de filet de sécurité en cas d’incident), mais de découpler ingestion et indexation avec les exclusion filters sur chaque log index :
resource "datadog_logs_index" "app_logs" {
  name = "app-logs"

  filter {
    query = "service:api OR service:worker"
  }

  exclusion_filter {
    name       = "drop-debug-and-healthchecks"
    is_enabled = true
    filter {
      query       = "status:debug OR http.url_details.path:/healthz"
      sample_rate = 0.0
    }
  }

  exclusion_filter {
    name       = "sample-info-logs"
    is_enabled = true
    filter {
      query       = "status:info"
      sample_rate = 0.1
    }
  }
}
Les logs exclus de l’index continuent d’exister dans Live Tail et dans l’archive S3 — vous ne perdez rien pour un post-mortem, vous arrêtez juste de payer l’indexation dessus. Pour les logs de conformité ou d’audit qu’il faut garder consultables sans les indexer en continu, basculez-les vers Flex Logs (0,05 $ par million d’événements stockés/mois en engagement annuel) plutôt que vers l’index standard à 1,70 $ — soit environ 97 % d’écart sur le stockage requêtable des logs à faible fréquence de consultation.
Sur une stack qui indexe aujourd’hui 100 % de ses logs bruts, un premier passage d’exclusion filters sur les niveaux debug/info et les endpoints de health check réduit typiquement le volume indexé de 40 à 60 % — sans toucher à un seul dashboard existant, puisque les requêtes sur les champs indexés restants continuent de fonctionner normalement.
Levier 2 — Reprendre la main sur la cardinalité des métriques
Metrics without Limits permet de définir, métrique par métrique, quels tags sont réellement indexés côté requête — sans changer ce qui est ingéré côté agent :
resource "datadog_metric_tag_configuration" "checkout_latency" {
  metric_name = "app.checkout.latency"
  metric_type = "distribution"
  tags        = ["env", "service", "region"]

  # exclut explicitement les tags haute cardinalité type
  # customer_id, request_id, pod_name du calcul des séries facturées
}
Avant de configurer quoi que ce soit, l’audit qui rapporte le plus vite : trier les métriques custom par nombre de tags distincts dans l’explorateur de métriques Datadog (menu Metrics > Summary, tri par “% used” et cardinalité). Dans la majorité des audits, 10 à 15 métriques concentrent 70-80 % de la cardinalité facturable — traiter ce top 15 avant de généraliser un audit métrique par métrique donne le meilleur ratio effort/gain.
Deux réflexes d’instrumentation à ancrer côté équipes produit, en amont plutôt qu’en rattrapage :
- Jamais de
request_id,session_id,user_idoupod_nameen tag sur une métrique custom — ces identifiants uniques appartiennent aux logs et aux traces, pas aux métriques. - Les histogrammes et distributions comptent chacun pour 5 métriques custom par combinaison de tags — les réserver aux mesures où la distribution complète (p50/p90/p99) apporte une valeur réelle, pas par défaut sur toute latence.
Levier 3 — Sampler l’APM par service, pas par réflexe global
L’APM ne se désactive pas en bloc — il se cible. Deux réglages distincts à ne pas confondre :
- L’ingestion sampling, côté agent ou tracer (
DD_APM_MAX_TPS/dd-tracesampling rules), décide combien de traces sont générées à la source. Baisser le taux d’ingestion réduit la facture mais peut faire manquer une trace rare et intéressante. - La retention filter, côté UI Datadog, décide combien de traces déjà ingérées sont indexées et conservées 15 jours. C’est le levier à privilégier en premier : garder 100 % des traces en erreur ou à forte latence, et échantillonner agressivement (5-10 %) les traces “nominales” sur les endpoints à fort volume comme les health checks ou le polling front-end.
Concrètement, sur les 31-40 $/hôte/mois de l’APM, la question à se poser hôte par hôte n’est pas “cet hôte fait-il partie de la prod” mais “cet hôte a-t-il déjà généré un incident qui aurait bénéficié de tracing distribué dans les 90 derniers jours”. Sur une flotte de 20-30 hôtes, il est fréquent qu’un quart tourne des workers batch ou des jobs cron qui n’ont jamais eu besoin de traces distribuées — les repasser en Infra Monitoring seul (15-23 $/hôte au lieu de 31-40 $) sans perte de couverture réelle.
Levier 4 — Surveiller sa propre consommation Datadog
Le point commun des factures qui dérapent : personne ne surveille l’usage Datadog avec Datadog. L’API /api/v2/usage/hourly_usage et les dashboards natifs Usage Attribution exposent la consommation par org unit, par équipe (via tag team) et par produit — ingestion de logs, hôtes APM, métriques custom actives. Un monitor simple sur la variation semaine sur semaine de ces métriques d’usage détecte un dérapage de cardinalité en quelques jours plutôt qu’à la réception de la facture mensuelle :
resource "datadog_monitor" "custom_metrics_spike" {
  name    = "Datadog usage - custom metrics ingested spike"
  type    = "metric alert"
  query   = "pct_change(avg(last_1w),last_1w):avg:datadog.estimated_usage.metrics.custom{*} > 0.3"
  message = "Hausse >30% des métriques custom ingérées vs semaine précédente — vérifier un déploiement récent ou un tag à haute cardinalité. @slack-finops"

  monitor_thresholds {
    critical = 0.3
  }
}
Ce monitor coûte une alarme standard et évite de découvrir un dérapage de cardinalité au moment du renouvellement contractuel — moment où la marge de négociation est la plus faible.
La méthode d’audit en trois passes
- Semaine 1 — cartographier sans rien couper. Usage Attribution par équipe/service, top 20 métriques par cardinalité, ratio logs ingérés vs indexés par index, liste des hôtes APM avec leur dernier incident tracé.
- Semaine 2 — traiter le top 20 %. Exclusion filters sur les index les plus volumineux, tag configuration sur les métriques les plus coûteuses, désactivation APM sur les hôtes sans historique d’incident. C’est là que se trouve 80 % du gain.
- Semaine 3 — instrumenter la gouvernance. Monitors sur les métriques d’usage Datadog elles-mêmes, revue trimestrielle calée sur le cycle de renouvellement du contrat, règle d’instrumentation documentée (tags interdits sur métriques custom) diffusée aux équipes produit.
Notre lecture
Le réflexe “on négocie une remise volume au renouvellement” traite le symptôme, pas la cause — et une remise de 15-20 % sur un volume mal maîtrisé reste plus cher qu’un volume assaini sans remise. Les audits FinOps que nous menons sur des stacks Datadog trouvent presque systématiquement un gain de 30 à 50 % sur les postes logs et métriques custom en 2-3 semaines de travail, sans dégrader la visibilité opérationnelle — parce que la plupart des données coupées n’étaient de toute façon jamais consultées. Un audit DevSecOps ou une revue FinOps ciblée permet de faire ce tri poste par poste sur votre volumétrie réelle, idéalement avant la date de renouvellement plutôt qu’après avoir signé.
Conclusion
Une facture Datadog qui explose n’est presque jamais un problème de nombre de serveurs — c’est un problème de logs indexés sans filtrage, de métriques taguées sans discipline, et d’APM activé par défaut plutôt que par besoin. Les trois leviers se configurent en Terraform, se déploient sans interruption de service, et le premier passage (exclusion filters + tag configuration sur le top 20 des métriques) tient dans un sprint. La gouvernance continue — un monitor sur sa propre consommation Datadog — est ce qui évite de refaire cet audit dans un an.
Sources : tarification Datadog, documentation Datadog — Metrics without Limits, documentation Datadog — exclusion filters sur les index de logs, documentation Datadog — Flex Logs, documentation Datadog — Usage Attribution, terraform-provider-datadog — datadog_logs_index.
Cet article vous a été utile ? Partagez-le.
Aller plus loin
Un sujet, une mission, une question ?
Distribuée accompagne des PME exigeantes sur la sécurité cloud, la supply chain CI/CD et la sécurité IA.
Réserver 15 min