Écosystème
Kubecost sur EKS : mesurer le vrai coût par équipe et par service
EKS facture un forfait global, pas un coût par équipe. Split Cost Allocation Data (natif AWS) et Kubecost : méthode concrète pour attribuer la facture par namespace et service.
Un cluster EKS de dix namespaces envoie une seule ligne sur la facture AWS : le coût des instances EC2 (ou Fargate) qui composent les node groups, plus le forfait control plane. Aucune répartition par équipe, par service ni par environnement — juste un total. Le rapport 2026 de Cast AI sur l’optimisation Kubernetes, basé sur des dizaines de milliers de clusters analysés, mesure une utilisation CPU moyenne de 8 % et mémoire de 20 % avant optimisation, en baisse par rapport à l’année précédente. Datadog arrive à une conclusion voisine dans son State of Cloud Costs : 83 % des coûts de conteneurs partent en ressources inactives, dont 54 % d’infrastructure surdimensionnée et 29 % de requêtes de pods surallouées. Sur un cluster mutualisé par plusieurs équipes, personne ne sait qui a causé quoi — donc personne ne corrige rien.
Deux voies existent pour sortir de ce brouillard : la fonctionnalité native AWS, gratuite, et Kubecost, l’outil tiers qui domine le marché de la visibilité Kubernetes depuis son rachat par IBM en 2024. Cet article détaille ce que chacune couvre réellement, où s’arrête le natif, et comment les mettre en œuvre sans y passer un sprint entier.
Ce qu’AWS offre déjà, gratuitement
Split Cost Allocation Data pour Amazon EKS, lancée en avril 2024, répartit le coût des nœuds EC2 et Fargate au niveau du pod dans le Cost and Usage Report (CUR), au prorata du CPU et de la mémoire réellement consommés — sans coût additionnel, disponible dans toutes les régions commerciales AWS. Deux évolutions récentes en élargissent la portée :
- Novembre 2024 : la fonctionnalité peut s’appuyer sur les métriques CloudWatch Container Insights pour affiner l’attribution pod par pod, y compris pour les charges GPU/accélérateurs (Trainium, Inferentia, GPU NVIDIA/AMD).
- Octobre 2025 : possibilité d’importer jusqu’à 50 labels Kubernetes custom par pod comme cost allocation tags —
team,cost-center,application,environmentdeviennent directement filtrables dans le CUR, sans outil supplémentaire.
Concrètement, une fois les tags de répartition activés dans Billing and Cost Management, chaque ligne de CUR pour un nœud EKS se scinde en sous-lignes par namespace et par label. C’est suffisant pour de la restitution finance mensuelle ou pour du chargeback trimestriel entre équipes — et ça ne demande ni Helm, ni composant à opérer sur le cluster.
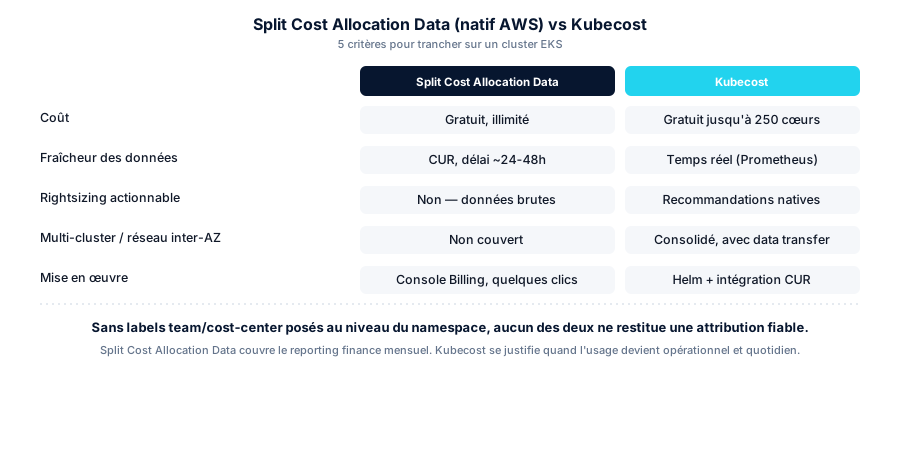
La limite structurelle : le CUR se met à jour avec un délai typique de 24 à 48 heures, et la maille d’analyse reste celle d’un rapport de facturation — pas un tableau de bord opérationnel qu’une équipe consulte au quotidien pour arbitrer un rightsizing.
Où Kubecost et OpenCost vont plus loin
Kubecost s’appuie sur OpenCost, le moteur de calcul de coût qu’IBM a fait entrer en incubation CNCF (licence Apache 2.0) après le rachat de Kubecost en septembre 2024 — la même acquisition a intégré l’outil dans la suite FinOps d’IBM aux côtés de Cloudability (ex-Apptio) et Turbonomic. Trois apports concrets par rapport au natif AWS :
- Temps réel plutôt que T+1 jour. Kubecost interroge Prometheus en continu — les dashboards reflètent l’état du cluster à quelques minutes près, ce qui permet de repérer un pic de coût pendant un déploiement plutôt qu’en fin de mois.
- Recommandations de rightsizing actionnables. Kubecost calcule, pod par pod, l’écart entre
requestset consommation réelle, et propose des valeurs derequests/limitscorrectives directement exploitables — pas juste un pourcentage d’idle. - Agrégation multi-cluster et coûts réseau. Au-delà d’un cluster EKS unique, Kubecost consolide plusieurs clusters (multi-région, multi-compte) et modélise les coûts de data transfer inter-AZ et inter-région, un poste que Split Cost Allocation Data ne couvre pas.
Pour affiner encore la précision, Kubecost peut s’intégrer directement au CUR AWS afin de reconstituer le taux réellement payé par ressource — Reserved Instances, Savings Plans et instances Spot inclus — plutôt qu’un tarif à la demande théorique, via un pipeline de réconciliation cloud dédié.
Combien ça coûte réellement
Le point souvent mal connu : Kubecost a un palier gratuit permanent, pas seulement un essai. Le tier Foundations (self-hosted) couvre jusqu’à 250 cœurs cumulés, clusters illimités dans ce plafond, rétention des métriques 15 jours, utilisateurs illimités, support multi-cloud (EKS, AKS, GKE, on-prem) et intégration OpenCost — largement suffisant pour une organisation avec un ou deux clusters de taille modeste. La version cloud gratuite, elle, plafonne à 50 nœuds et 5 utilisateurs, toujours avec 15 jours de rétention. AWS distribue par ailleurs un bundle Kubecost optimisé AWS sans coût additionnel via l’add-on EKS.
Au-delà de 250 cœurs ou pour des fonctionnalités avancées (SSO, RBAC fin, SLA support), il faut basculer sur les paliers Enterprise Self-Hosted ou Enterprise Cloud — tarification sur devis uniquement. Les montants qui circulent sur des déploiements réels vont d’environ 40 000 à 144 000 $/an, un ordre de grandeur à mettre en face du volume de compute Kubernetes réellement en jeu avant de s’engager.
Installation concrète sur un cluster existant
Le chemin le plus direct passe par le chart Helm officiel, avec l’intégration CUR configurée dès l’installation :
resource "kubernetes_secret" "kubecost_cur_integration" {
  metadata {
    name      = "cloud-integration"
    namespace = "kubecost"
  }
  data = {
    "cloud-integration.json" = jsonencode({
      aws = [{
        athenaBucketName = "aws-athena-query-results-kubecost"
        athenaRegion     = "eu-west-3"
        athenaDatabase   = "athenacurcfn_kubecost_cur"
        athenaTable      = "kubecost_cur"
        projectID        = "470508210570"
        masterPayerARN   = "arn:aws:iam::470508210570:root"
      }]
    })
  }
}

resource "helm_release" "kubecost" {
  name             = "kubecost"
  repository       = "oci://public.ecr.aws/kubecost"
  chart            = "cost-analyzer"
  namespace        = "kubecost"
  create_namespace = true

  values = [yamlencode({
    kubecostProductConfigs = {
      clusterName            = "prod-eks-eu-west-3"
      cloudIntegrationSecret = kubernetes_secret.kubecost_cur_integration.metadata[0].name
    }
    prometheus = {
      server = { retention = "15d" }
    }
  })]
}
Côté attribution par équipe, la brique qui rend le découpage exploitable — que ce soit pour Kubecost ou pour Split Cost Allocation Data — est la discipline de labeling au niveau du namespace, pas du pod :
apiVersion: v1
kind: Namespace
metadata:
  name: team-checkout
  labels:
    team: checkout
    cost-center: "eng-payments"
    env: production
Sans ces labels posés en amont (idéalement via un admission controller ou une policy OPA/Kyverno qui les rend obligatoires à la création), l’outil le plus sophistiqué du marché retombe sur un découpage par défaut au niveau du namespace technique — rarement aligné avec l’organigramme réel des équipes produit.
Natif ou Kubecost : comment trancher
Sur les audits FinOps que nous menons chez des organisations opérant EKS, trois signaux orientent vers Kubecost plutôt que de s’arrêter à Split Cost Allocation Data :
- Plus de 3-4 équipes produit partagent le même cluster et ont besoin d’un chargeback consulté en continu, pas seulement en fin de mois par la finance.
- Le rightsizing des
requests/limitsest un chantier actif — les recommandations automatisées de Kubecost font gagner des semaines par rapport à un export CUR à retraiter manuellement. - Plusieurs clusters ou comptes AWS doivent être consolidés dans une seule vue, avec les coûts de data transfer inter-cluster inclus.
À l’inverse, une organisation avec un cluster EKS unique, une seule équipe qui l’opère et un besoin de reporting mensuel pour la finance n’a probablement pas besoin d’opérer un composant Kubecost supplémentaire : Split Cost Allocation Data, activée en quelques clics dans Billing and Cost Management, couvre le besoin à coût nul.
Notre lecture
Le vrai coût caché sur EKS n’est presque jamais le control plane à 73 $/mois évoqué dans notre comparatif ECS vs EKS vs Fargate — c’est la capacité provisionnée et jamais consommée, invisible tant qu’elle n’est pas rattachée à une équipe qui peut agir dessus. Activer Split Cost Allocation Data est un chantier d’une demi-journée qui devrait être un standard sur tout cluster EKS multi-équipes, gratuit ou pas. Kubecost ne devient un investissement justifié qu’au moment où la question passe de « combien coûte le cluster » à « qui doit rendre des comptes sur quelle ligne » — et où quelqu’un doit effectivement agir sur les recommandations en continu. Un audit DevSecOps permet de trancher sur votre topologie réelle avant d’ajouter un composant de plus à opérer.
Conclusion
EKS ne facture jamais par équipe — c’est un choix délibéré d’AWS qui laisse l’attribution du coût à la charge de l’opérateur du cluster. Split Cost Allocation Data comble l’essentiel du besoin gratuitement, avec un délai T+1 jour acceptable pour du reporting financier. Kubecost (et son moteur open source OpenCost) prend le relais quand le besoin devient opérationnel : temps réel, rightsizing actionnable, multi-cluster. Le point commun aux deux approches, souvent négligé : sans labels team/cost-center posés au niveau du namespace dès la création, aucun outil ne peut reconstituer une attribution fiable a posteriori.
Sources : AWS — lancement Split Cost Allocation Data pour EKS, AWS — support des labels Kubernetes (octobre 2025), AWS — métriques CloudWatch Container Insights (novembre 2024), documentation AWS — labels Kubernetes pour l’attribution de coût EKS, Kubecost — pricing et paliers, TechCrunch — rachat de Kubecost par IBM, Cast AI — 2026 State of Kubernetes Optimization Report.
Cet article vous a été utile ? Partagez-le.
Aller plus loin
Un sujet, une mission, une question ?
Distribuée accompagne des PME exigeantes sur la sécurité cloud, la supply chain CI/CD et la sécurité IA.
Réserver 15 min