Écosystème
Grafana Cloud vs Datadog vs Honeycomb : quel outil d'observabilité AWS en 2026
CloudWatch, Grafana Cloud, Datadog, Honeycomb : quatre modèles de tarification radicalement différents pour le même besoin. Comparatif chiffré pour choisir son outil d'observabilité AWS en 2026.
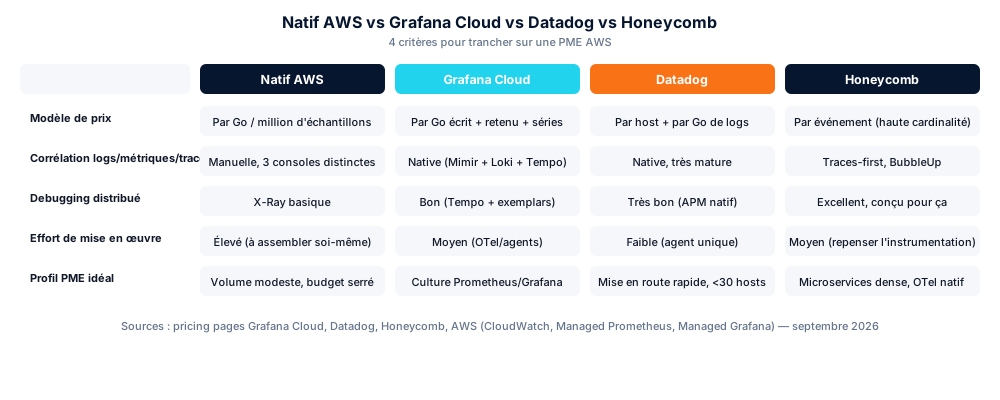
Une organisation qui démarre sur AWS opère avec CloudWatch par défaut — c’est natif, activé sans rien faire, et facturé à l’usage. Le moment où la question « faut-il un outil d’observabilité tiers » se pose vraiment arrive presque toujours au même endroit : un incident de production où la première heure est passée à recouper trois consoles (CloudWatch Logs, CloudWatch Metrics, X-Ray) pour reconstituer ce qui s’est passé, alors qu’un seul écran aurait suffi. Trois outils tiers reviennent systématiquement dans cette conversation — Grafana Cloud, Datadog et Honeycomb — avec trois philosophies et trois modèles de tarification qui n’ont presque rien en commun.
Cet article compare les quatre options (natif AWS inclus) sur des critères concrets : ce que chacune facture réellement en 2026, ce qu’elle corrèle nativement, et pour quel profil de organisation elle a du sens. Il complète notre article sur la réduction d’une facture Datadog qui explose — ici la question est en amont : faut-il payer un tiers, et lequel, avant même d’avoir un problème de facture.
Le socle natif AWS : CloudWatch, Managed Prometheus, Managed Grafana
Trois briques AWS gratuites ou quasi gratuites couvrent l’essentiel du besoin avant d’envisager un tiers :
- CloudWatch Logs : ingestion à 0,50 $/Go en classe Standard, ou 0,25 $/Go en classe Infrequent Access (support complet de Logs Insights depuis début 2026) — puis 0,03 $/Go/mois de stockage archive.
- CloudWatch Container Insights pour EKS : en mode enhanced observability, 0,21 $/million d’observations, dégressif au-delà d’un milliard par mois.
- Amazon Managed Service for Prometheus (AMP) : 0,09 $/million d’échantillons ingérés sur les 2 premiers milliards mensuels, 0,0001 $/million d’échantillons interrogés, 0,03 $/Go/mois de stockage — API-compatible Prometheus, donc migrable sans réécrire les requêtes PromQL.
- Amazon Managed Grafana (AMG) : 9 $/éditeur/mois et 5 $/lecteur/mois, essai gratuit de 90 jours avec 5 utilisateurs — un simple frontal de visualisation, pas un backend de stockage.
La combinaison AMP + AMG + CloudWatch couvre dashboards, alerting et rétention à un coût qui reste bas tant que le volume est modeste. La limite structurelle n’est pas le prix : c’est l’absence de corrélation native. CloudWatch Logs, CloudWatch Metrics et X-Ray restent trois produits distincts avec trois consoles distinctes — remonter d’une alerte de latence à la ligne de log puis à la trace qui l’explique demande de la tuyauterie manuelle (ou beaucoup de disciplines de tagging) que les trois outils tiers ci-dessous industrialisent nativement.
Grafana Cloud : la pile open source, facturée à l’usage
Grafana Cloud s’appuie sur sa propre pile open source — Mimir (métriques, compatible Prometheus), Loki (logs), Tempo (traces) — hébergée et managée, avec un modèle de tarification granulaire plutôt que par palier :
| Composant | Tarif Pro (au-delà du free tier) |
|---|---|
| Métriques | 6,50 $ / 1 000 séries actives/mois |
| Logs, traces, profils | 0,40 $/Go à l’écriture + 0,05 $/Go de traitement + 0,10 $/Go/mois de rétention |
| Frais de plateforme | 19 $/mois (Pro) |
| Free tier permanent | 10 000 séries actives, 50 Go logs, 50 Go traces, 50 Go profils, rétention 14 jours |
Le point fort pour une organisation technique : la compatibilité native OpenTelemetry et Prometheus signifie qu’une instrumentation déjà en place (exporters Prometheus, OTel Collector) se branche sans réécriture. C’est aussi l’option la plus proche d’un chemin de sortie propre — Mimir et Loki sont open source, donc un retrait vers du self-hosted reste réaliste si le volume justifie un jour d’opérer l’infra soi-même. Le revers : la facturation multi-axes (par Go écrit, par Go retenu, par série) est plus difficile à prévoir à l’avance qu’un prix par hôte, et demande une vraie discipline de cardinalité sur les métriques dès le départ.
Datadog : le tout-en-un, prévisible par host mais large par défaut
Datadog reste l’option la plus simple à faire adopter par une équipe qui ne veut pas gérer d’agent d’instrumentation par produit :
- Infrastructure Monitoring : 15 $/host/mois (engagement annuel), 23 $/host/mois en Enterprise.
- APM : 31 $/host/mois en plus de l’Infrastructure (annuel).
- Log Management : 0,10 $/Go ingéré, puis indexation standard à 1,70 $/million d’événements/mois (rétention 15 jours, annuel) — ou stockage long terme Flex à 0,05 $/million d’événements/mois pour l’historique peu consulté.
Plus de 700 intégrations prêtes à l’emploi (dont une couverture AWS très large — Lambda, RDS, ECS, EKS, API Gateway) et une seule console pour infra, APM, logs et RUM expliquent l’adoption massive. Le prix à payer est la dérive budgétaire classique documentée dans notre article sur la facture Datadog qui explose : le modèle par host encourage à instrumenter large, et chaque produit activé (APM, logs, RUM, Synthetics) s’additionne indépendamment. Pour une organisation de moins de 30 hosts avec un besoin de mise en route rapide et peu de temps d’ingénierie plateforme à investir, c’est souvent l’option la plus rentable malgré un prix nominal plus élevé — le coût caché de Grafana Cloud ou Honeycomb est le temps d’ingénieur pour assembler la pile.
Honeycomb : le pari du traçage haute cardinalité
Honeycomb part d’un principe différent des deux précédents : plutôt que de séparer logs, métriques et traces, tout est un « événement » — une ligne large, haute cardinalité, interrogeable en quelques secondes via son moteur BubbleUp pour isoler automatiquement la dimension responsable d’une anomalie (une seule requête, un seul tenant, une seule version de déploiement).
- Free : jusqu’à 20 millions d’événements/mois.
- Pro : à partir de 150 $/mois jusqu’à 750 millions d’événements/mois.
- Changement de grille tarifaire au 1er juillet 2026 : le nouveau taux Pro passe à 3 $/million d’événements (contre 1,30 $/million sur les plans legacy), en échange de l’inclusion des métriques time series et des fonctionnalités d’IA (Honeycomb Intelligence, Canvas, MCP).
- Enterprise : sur devis, base de 10 milliards d’événements/an.
Honeycomb n’a pas d’agent d’infrastructure équivalent à celui de Datadog ni de stack métriques aussi mature que Grafana Cloud avant 2026 — c’est un outil de debugging distribué d’abord, pensé pour des équipes qui instrumentent déjà en OpenTelemetry et qui ont un vrai problème de traçage sur une architecture microservices complexe. Sur une organisation avec une poignée de services et peu de trafic, l’investissement d’apprentissage (le modèle par événements larges demande de repenser l’instrumentation) est rarement rentabilisé — Honeycomb prend tout son sens à partir du moment où localiser un bug de production prend des heures de corrélation manuelle entre logs et traces.
Simulation chiffrée sur un profil type type
Hypothèses : 15 hosts EC2/ECS, 40 Go de logs/mois, 8 000 séries de métriques actives, 20 millions de traces/spans par mois.
| Natif AWS | Grafana Cloud | Datadog | Honeycomb | |
|---|---|---|---|---|
| Métriques | AMP : ~55 $ | ~52 $ (8k séries) | Inclus dans le prix/host | Inclus (events) |
| Logs (40 Go) | CloudWatch Standard : ~20 $ | ~18 $ (write+retain) | Ingestion + indexation : ~70-100 $ | Inclus (events) |
| Infra + APM | AMG : ~50-90 $ (licences) | Frais plateforme : 19 $ | 15 hosts infra + APM : ~690 $ | — |
| Traces/events | X-Ray : quelques $ | Inclus dans logs/traces | Inclus dans APM | ~20M events : proche du plan Free/Pro selon volume exact |
| Ordre de grandeur mensuel | ~150-200 $ | ~150-200 $ | ~800-900 $ | 150-300 $ (Pro) |
Ces montants sont des ordres de grandeur, pas des devis — ils dépendent fortement du taux d’échantillonnage des traces, de la rétention choisie et de la densité de tags/labels. Ils montrent surtout l’écart structurel : Datadog facture la largeur de la couverture (chaque host, chaque produit), Grafana Cloud et CloudWatch facturent le volume brut, Honeycomb facture le nombre d’événements indépendamment du nombre de hosts — un profil qui devient très favorable si l’infrastructure est containerisée et dense (peu de hosts, beaucoup de requêtes).
OpenTelemetry : la police d’assurance contre le vendor lock-in
Le choix le moins risqué à long terme n’est pas l’outil lui-même mais la couche d’instrumentation en amont. Standardiser sur OpenTelemetry (OTel) — SDK d’instrumentation + Collector — permet de changer de backend sans réinstrumenter le code applicatif :
receivers:
  otlp:
    protocols:
      grpc:
      http:

exporters:
  otlphttp/grafana_cloud:
    endpoint: "https://otlp-gateway-prod-eu-west-0.grafana.net/otlp"
    auth:
      authenticator: basicauth/grafana_cloud
  datadog:
    api:
      key: ${env:DD_API_KEY}
      site: datadoghq.eu

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [otlphttp/grafana_cloud, datadog]
    metrics:
      receivers: [otlp]
      exporters: [otlphttp/grafana_cloud]
    logs:
      receivers: [otlp]
      exporters: [otlphttp/grafana_cloud]
Un Collector configuré ainsi peut envoyer en double pendant une phase de comparaison réelle (pas juste sur des chiffres de pricing page) avant de trancher, puis basculer sur un seul exportateur sans toucher au code instrumenté. C’est l’architecture que nous recommandons systématiquement, quel que soit le backend retenu ensuite.
Notre lecture
Trois signaux orientent le choix sur les audits que nous menons :
- Moins de 20 hosts, équipe technique restreinte, besoin de mise en route en jours plutôt qu’en semaines → Datadog reste le choix par défaut le plus sûr, budget prévisible côté “combien de hosts j’ai” plutôt que côté volume de données — à condition de garder un œil sur les produits activés au fil du temps (voir notre guide sur la facture Datadog).
- Équipe avec de la culture Prometheus/Grafana existante, sensibilité au coût à l’échelle, appétence pour garder une option de self-hosting future → Grafana Cloud, avec une vraie discipline de cardinalité sur les métriques dès le premier jour pour éviter la même dérive qu’ailleurs.
- Architecture microservices dense, dette de debugging distribué réelle (pas hypothétique), équipe déjà en OpenTelemetry → Honeycomb, en le complétant avec CloudWatch ou Grafana Cloud pour le monitoring infra classique qu’il ne couvre pas nativement.
Pour une organisation qui démarre, rester sur CloudWatch + Managed Prometheus + Managed Grafana reste défendable bien plus longtemps que ne le suggèrent les commerciaux des trois outils tiers — le seuil de bascule est atteint quand le temps perdu à corréler manuellement plusieurs consoles dépasse, sur un trimestre, le coût de l’abonnement. Un audit DevSecOps permet de chiffrer ce seuil sur votre volumétrie réelle plutôt que sur une estimation de pricing page.
Conclusion
Il n’y a pas de meilleur outil d’observabilité dans l’absolu en 2026 — il y a quatre modèles de tarification qui récompensent des profils d’usage différents. CloudWatch et la pile Managed AWS restent la base gratuite ou quasi gratuite à ne quitter qu’avec une raison précise. Datadog vend la simplicité d’un prix par host au prix d’une largeur de couverture qui s’additionne vite. Grafana Cloud vend la compatibilité open source et un contrôle fin du coût, en échange d’un effort d’assemblage plus élevé. Honeycomb vend la vitesse de debugging distribué, réservée aux organisations qui en ont un besoin réel et mesurable. Dans tous les cas, instrumenter en OpenTelemetry en amont rend la décision réversible — ce qui compte davantage que le choix initial lui-même.
Sources : Grafana Cloud — pricing, Datadog — pricing, Honeycomb — pricing, Honeycomb — 2026 Pro Plan Changes, AWS — Amazon Managed Service for Prometheus pricing, AWS — Amazon Managed Grafana pricing, AWS — CloudWatch pricing.
Cet article vous a été utile ? Partagez-le.
Aller plus loin
Un sujet, une mission, une question ?
Distribuée accompagne des PME exigeantes sur la sécurité cloud, la supply chain CI/CD et la sécurité IA.
Réserver 15 min